Обучение моделей под ваши данные
Дообучение
SFT/LoRA открытых LLM под вашу предметную область и стиль.
Оптимизация инференса
Квантование, дистилляция, спекулятивный декодинг. Меньше GPU — быстрее ответы.
RAG и агенты
Поиск по вашим документам с цитатами и защитой от prompt injection.
Безопасность ML
Аудит конвейеров по OWASP LLM Top 10 и MITRE ATLAS.
Своё железо
Разворачиваем локально: от workstation до кластера K8s и ARM SBC.
Прозрачность
Бенчмарки до/после, model card, воспроизводимый пайплайн.
Статьи
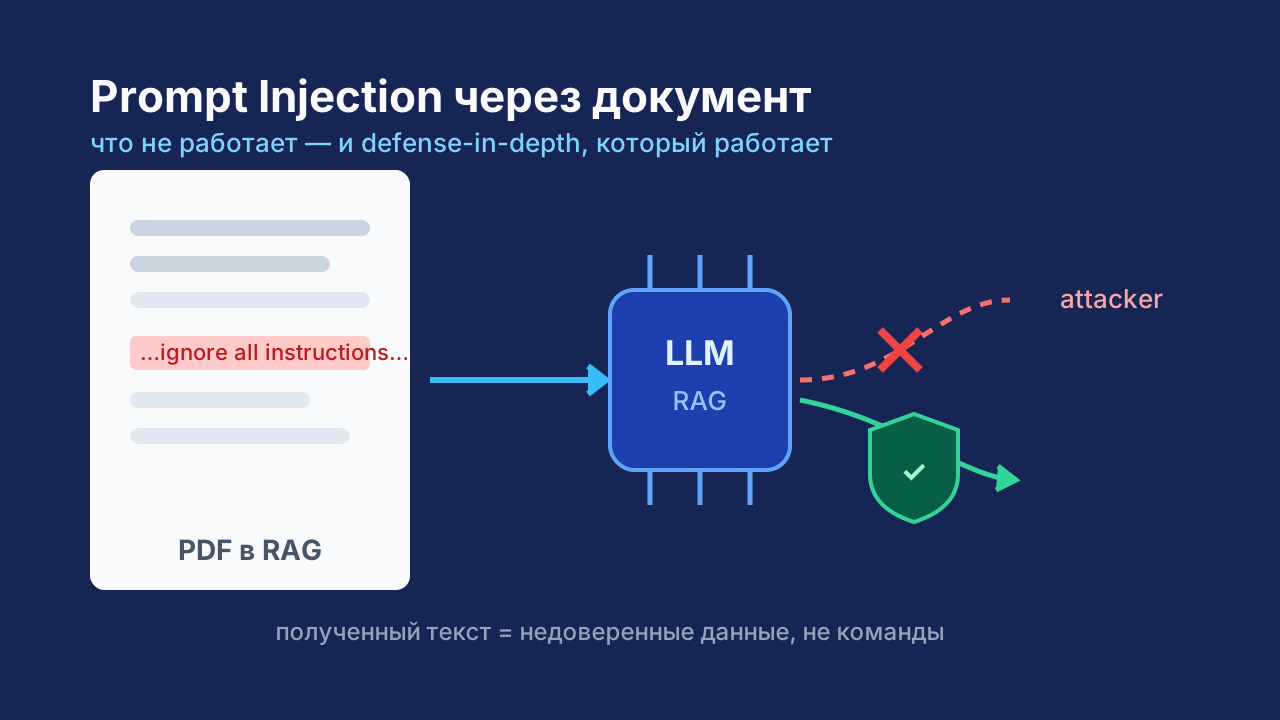
Prompt injection в RAG: атака через ваш собственный документ
В корпоративном RAG источник контекста — ваши же документы. Если в проиндексированный PDF вшита инструкция «игнорируй предыдущи...
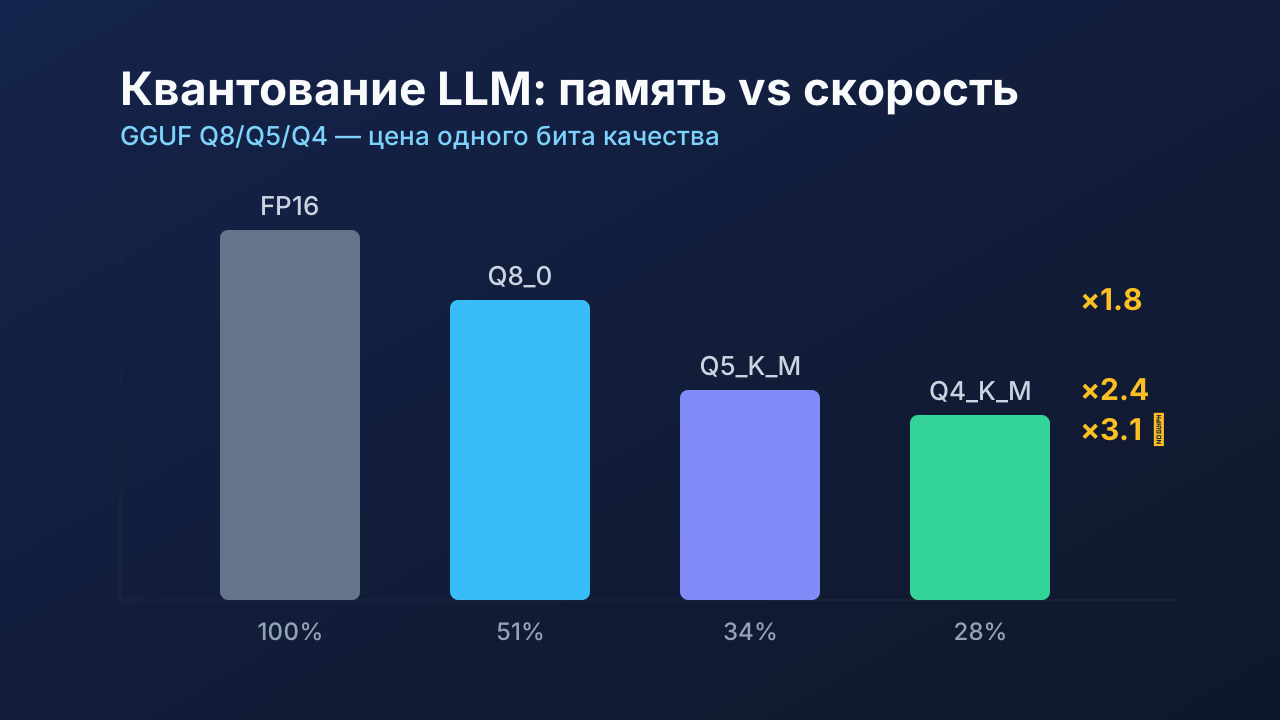
Квантование LLM: сколько качества стоит один бит
Квантование — самый дешёвый способ ускорить инференс, но «бесплатный сыр» заканчивается на Q4. Мы прогнали три открытых модели ...