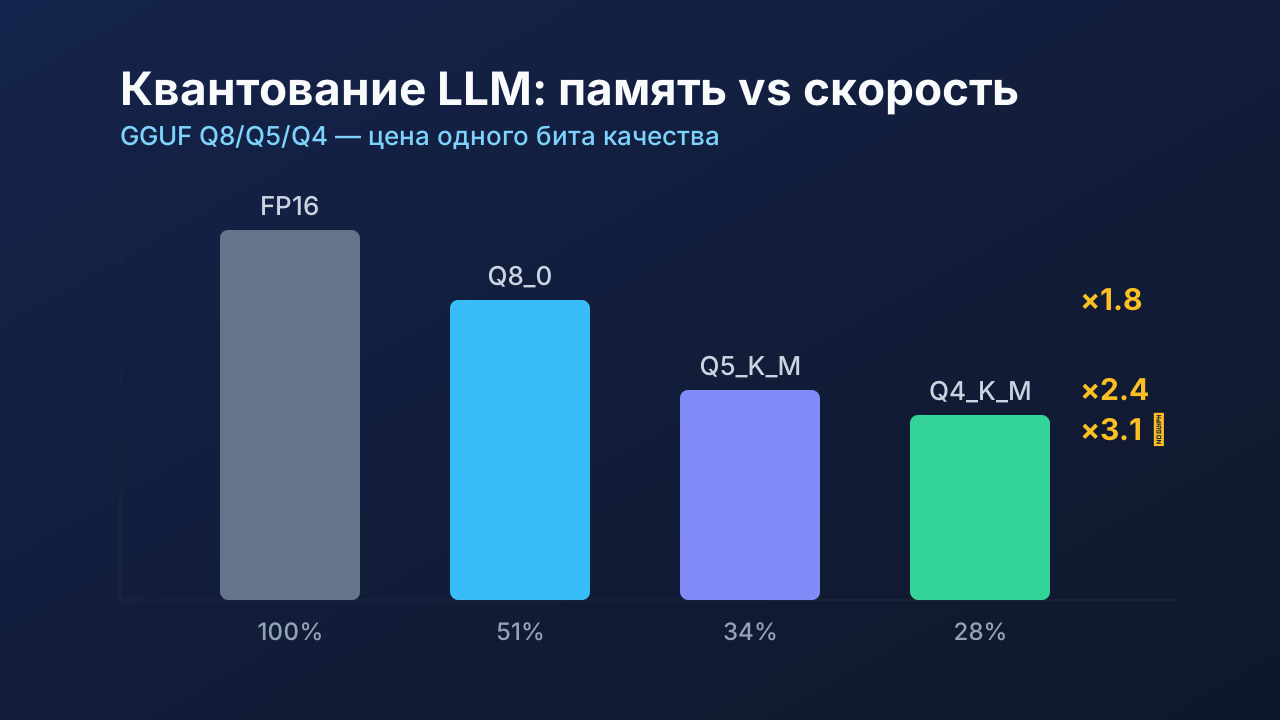
Квантование LLM: сколько качества стоит один бит
Квантование — самый дешёвый способ ускорить инференс, но «бесплатный сыр» заканчивается на Q4. Мы прогнали три открытых модели (7B, 13B, 34B) через набор задач и зафиксировали, где именно начинается деградация.
Методика
- Форматы: GGUF (llama.cpp, кванты Q4_K_M, Q5_K_M, Q8_0) и AWQ 4-bit (vLLM);
- Метрики: перплексия на ru-корпусе, точность извлечения фактов из документов, латентность P95, пиковая память;
- Железо: RTX 4090 24 GB и ARM SBC с RK3588.
Результаты
| Конфиг | Перплексия (Δ к FP16) | Скорость | Память |
|---|---|---|---|
| Q8_0 | +0.1% | ×1.8 | 51% |
| Q5_K_M | +0.4% | ×2.4 | 34% |
| Q4_K_M | +1.9% | ×3.1 | 28% |
| AWQ 4-bit | +1.2% | ×4.2 (батч) | 27% |
Практический вывод: Q5_K_M — «мёртвая зона», качество почти не отличается от Q8, а экономия памяти уже есть. Q4_K_M уже заметно хуже на извлечении фактов (−4…7 п.п. на узких доменах), но отлично подходит для чат-задач. Для RAG с цитатами мы не рекомендуем уходить ниже Q5 — ссылки на источники начинают «плыть».
Что в следующий раз
Дистилляция: когда дешевле один раз обучить 7B-ученика до уровня 34B-учителя, чем гонять квантованного учителя.